
网页能打开、端口能连通,不代表页面展示了正确的业务内容。对企业门户、内部知识库和只读查询页,可以用 Uptime Kuma 的 HTTP 关键词检测,把“返回了响应”升级为“响应里有预期内容”;再用独立测试监控演练告警和恢复。但它不执行浏览器 JavaScript,也不证明登录、下单或数据库事务完成。
本文采用 Uptime Kuma 2.5.6 的官方文档和代码作为操作示例,面向已经具备 Docker Compose 的 Linux 主机。适用目标是 HTTP/HTTPS 返回体中存在稳定成功标识的页面。单页应用、验证码、需要交互登录的流程以及交易正确性,应另做合成事务或业务指标监控。
先把“能连上”和“能办事”分开
| 检查层 | 实际回答的问题 | 仍可能漏掉什么 |
|---|---|---|
| TCP端口 | 从探针能否建立连接 | 错误页面、依赖故障、内容异常 |
| HTTP状态 | 最终响应是否满足设置的状态码 | 返回200的维护页、登录页、空壳页面 |
| HTTP关键词 | 返回体是否含区分大小写的指定字面子串 | 前端渲染结果、完整交易、深层数据正确性 |
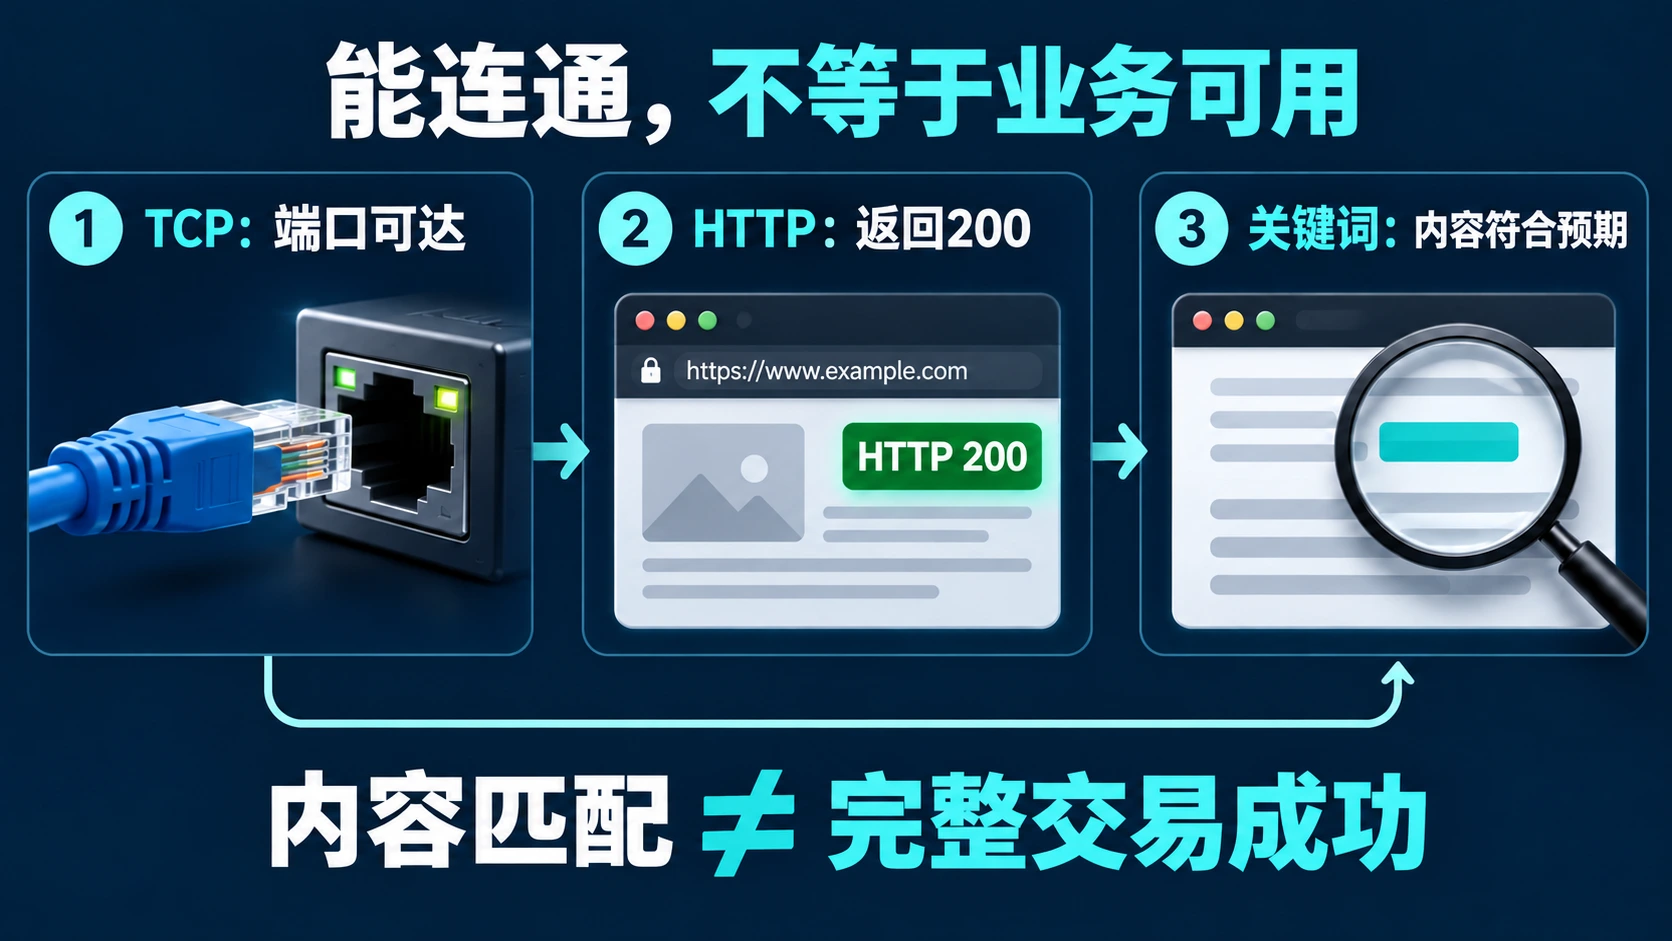
图:本文制作的检测边界示意。端口和内容检测互相补充,不能直接替代业务验收。
例如,知识库首页的标题与正常标识一起出现在服务端返回的 HTML 中,适合内容检测;页面只有 JavaScript 容器,标题要等浏览器执行脚本才出现,就不适合直接照搬。不要用所有页面共有的公司名作标识,维护页也可能带同样的公司名。
已有的服务器告警处理机制讨论责任人与闭环;本篇只解决探测条件设计和单项告警链路演练,不重做告警平台选型。
部署前先确认四个条件
- 探针能解析并访问目标域名,出站网络和通知渠道可用。目标只允许内网访问时,把探针放在能到达它的网段;不要把内网业务暴露到公网来迁就监控。
- 把探针与被监控应用分开。两者同机时,主机断电可能让应用和报警者同时消失;同机只能作为试用,不能宣称覆盖整机或站点故障。
- 持久化数据使用本地磁盘卷。官方明确不支持把数据目录放在 NFS 上。本例用 SQLite 和本地 Docker named volume,不涉及外部 MariaDB。
- 有获准的运维入口、备份空间与通知接收人。首次初始化从 SSH 隧道访问,管理端口仅绑定本机回环地址;不要开放匿名管理入口。
照片:Rodzilla,Dell PowerEdge850,2005年拍摄;Wikimedia Commons原图,CC BY 2.5。外部实拍,非本文或煜企现场。这里用于说明探针依赖自己的物理电源、网卡与主机;不是推荐该旧型号,也不是本方案实测证明。

用固定版本启动,先守住管理入口
以下目录和测试域名均为操作示例。先检查 Docker 与 Compose,任何一项不可用都停止,不要直接复制安装脚本到生产主机。
docker version
docker compose version
mkdir -p "$HOME/uptime-kuma"
cd "$HOME/uptime-kuma"
预期:Docker 客户端和服务端信息均能读取,Compose 能输出版本。若出现权限或连接错误,先按企业既有变更流程修复 Docker;不要通过给套接字放开所有权限绕过。
将下面内容保存为本目录的 compose.yaml。这个例子明确绑定回环地址,不使用官方示例中默认的全部网卡监听;不挂载 Docker socket,也不启用 host 网络。
services:
  uptime-kuma:
    image: louislam/uptime-kuma:2.5.6
    restart: unless-stopped
    ports:
      - "127.0.0.1:3001:3001"
    volumes:
      - uptime-kuma-data:/app/data
volumes:
  uptime-kuma-data:
启动并查看映射、日志。
docker compose config --quiet
docker compose pull
docker compose up -d
docker compose ps
docker compose logs --tail=80 uptime-kuma
预期:配置校验通过,容器持续运行,映射为本机回环地址。初始的 health: starting 不等于故障;等待初始化后检查健康状态与日志。如果反复重启、磁盘不足、数据权限错误或监听到了全部网卡,先停止接入业务监控,修正后重新检查。不要把容器 Running 记为业务检测已验收。
在自己的电脑上建立隧道。示例中的账号和主机必须换成已授权的 SSH 入口;若本地3001端口被占用,改用另一个本地端口。
ssh -N -L 127.0.0.1:3001:127.0.0.1:3001 ops@monitor-host.example.com
在本地浏览器访问隧道对应的本地3001端口,先在数据库设置中选择 SQLite,完成数据库初始化后再创建管理员,并启用支持的双因素认证。反向代理和公网访问属于额外部署设计,不在这份最小方案中默认开启。
先验证原始响应,再设置HTTP关键词监控
从探针主机做一次人工基线检查。目标地址应为获准访问的只读页面;不要把账号、Cookie或通知密钥放进命令或截图。
curl --connect-timeout 5 --max-time 10 \
  --silent --show-error --dump-header baseline.headers \
  --output baseline.html \
  https://portal.example.com/health/readiness
head -n 12 baseline.headers
grep -F -- 'PORTAL_READY_V1' baseline.html
本例标识是示例,需要应用负责人提供实际成功响应中的稳定字面子串。命令不跟随重定向。预期为 HTTP 200 且 grep 找到标识。若响应是302登录跳转、403访问拒绝,或页面源码没有这个标识,先处理认证、网络或页面类型问题,不能靠扩大成功状态范围让它变绿。若自建健康端点,必须由应用按依赖就绪状态生成,静态写死的成功标识不能证明依赖健康。
在 Uptime Kuma 新建专用测试监控,类型选 HTTP(s) - Keyword,并按下表核对字段。管理界面不同语言的字段名称可能略有差异。
| 字段 | 本例设置 | 判断与注意事项 |
|---|---|---|
| URL | 经授权的只读就绪页 | 和人工检查用同一个地址;探针来源网络要记录 |
| Keyword | 应用成功标识 | 区分大小写,字面子串,不是正则表达式 |
| Accepted Status Codes | 仅200 | 不把301、302、403或500加入成功范围 |
| Max Redirects | 0 | 本例就绪页不该跳转;使用最终规范地址 |
| Heartbeat Interval | 60秒 | 示例值,结合目标负载和告警时效调整 |
| Retries | 2 | 首次失败后再重试两次,期间可能为PENDING |
| Retry Interval | 60秒 | 超时、重试和通知投递使实际告警时间浮动 |
| Notifications | 指定接收人或值班渠道 | 先用测试按钮确认通知渠道,再做下文演练 |
监控看到的证书、DNS与HTTP结果来自其运行位置。笔记本能打开而容器报错,优先比较两处的DNS、代理、路由和证书链,不要直接关闭 TLS 校验。需要从容器网络排查时,采用组织批准的诊断工具,不临时给容器增加特权。
不停生产服务,也能演练故障与恢复
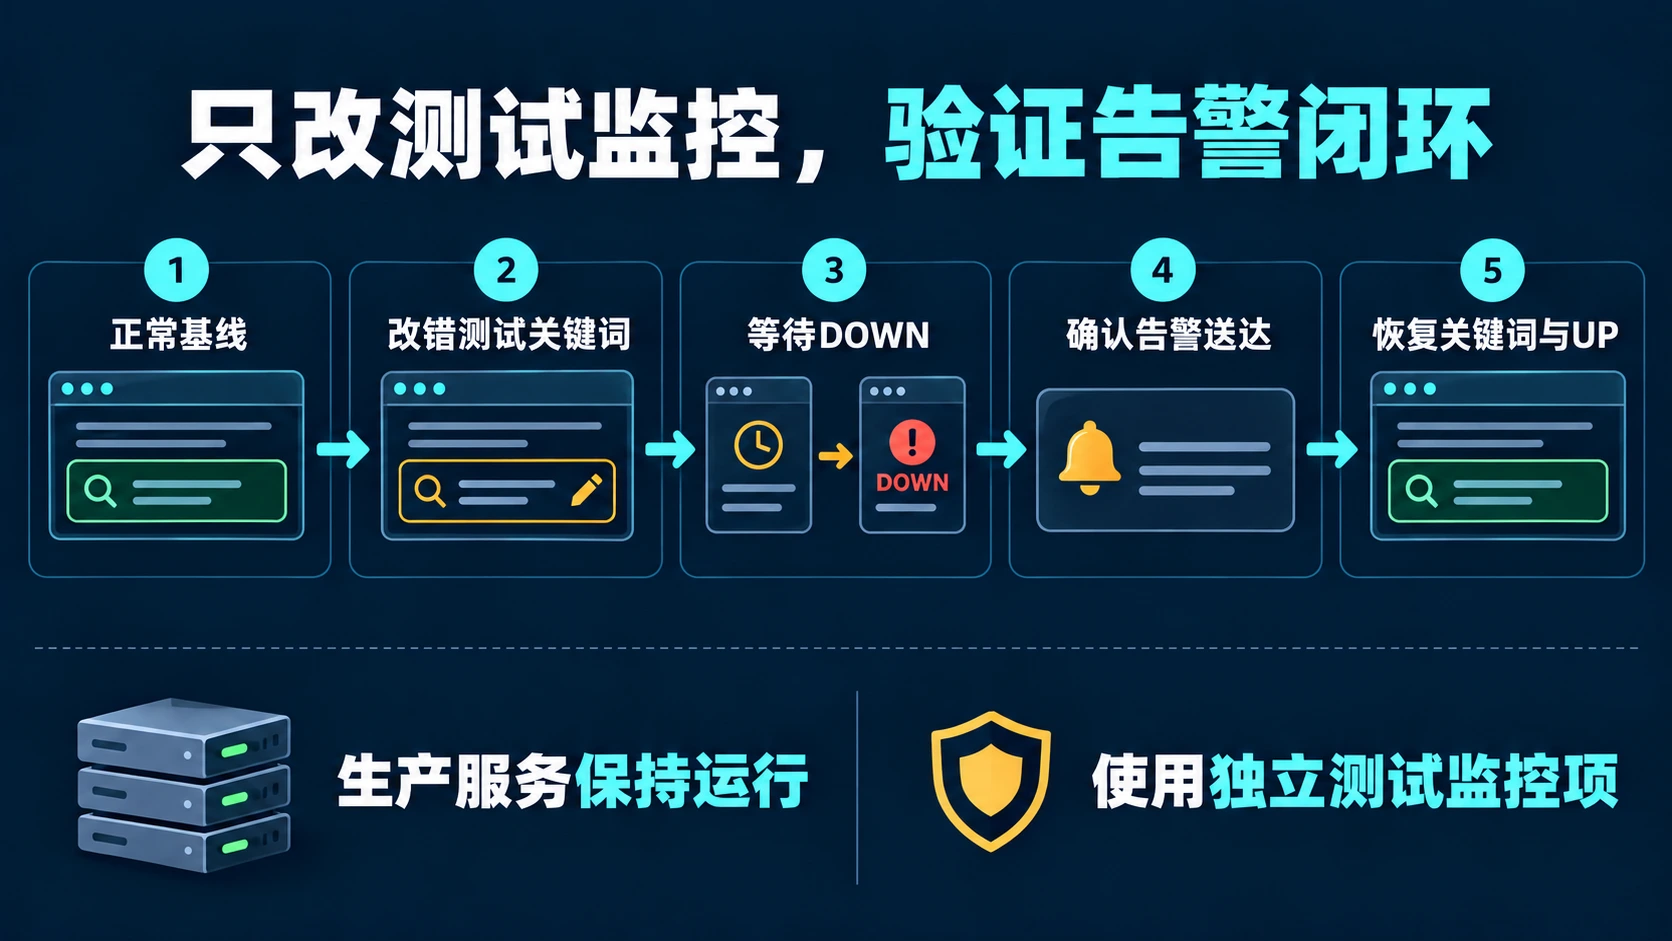
图:本文制作的受控演练流程。改的是测试监控条件,业务服务保持运行;图片不是已完成演练的回执。
先让专用测试监控稳定为 UP,保存响应标识、通知渠道、探针位置和时间基线。测试通知按钮成功,只说明渠道在当时可用,不代表故障检测链路已通过。
- 把测试监控关键词临时改成响应中不存在的演练标识,保存。不要改业务页面,也不要停生产网站。
- 观察首次失败、PENDING到DOWN的变化,记录真正收到故障通知的时间。不要承诺“必定120秒到达”:检查耗时、重试、调度和通知渠道都会影响结果。
- 核对通知是否指向正确监控、是否能找到负责人。未收到时分开查:状态未DOWN就查探测与重试;状态已DOWN而无消息就查通知绑定和渠道投递。
- 恢复原来的正确关键词,等待监控回到UP,并确认按通知设置收到恢复消息。恢复后核对没有遗留错误关键词。
- 记录告警耗时和恢复耗时,值班人确认后再把同样的方法用于正式监控;正式项仍要逐项做基线验证。
| 验收项 | 通过条件 | 不通过时停止在哪里 |
|---|---|---|
| 正常基线 | 只读响应200且成功标识存在 | 不建立“已可用”结论 |
| 故障发现 | 错误标识使测试项进入DOWN | 不上线同类检测条件 |
| 告警送达 | 真实接收端收到对应故障消息 | 不依赖该渠道值班 |
| 恢复闭环 | 正确标识恢复UP并核对恢复通知 | 不把演练记为完整通过 |
| 探针故障域 | 有外部手段发现探针失联 | 同机方案不宣称覆盖整机故障 |
本演练验证的是“响应内容不符→监控变为故障→通知→恢复”链路,不验证登录交易,也没有模拟断电或整站网络失联。
备份的是完整数据目录,不是旧版JSON导出
Uptime Kuma v2 不再提供旧版的 JSON Backup/Restore。对本例的 SQLite本地卷方案,安排维护窗口,先停容器再复制完整数据。停止探针期间监控与通知中断,应让值班人知情,并由另一条监控路径覆盖。
cd "$HOME/uptime-kuma"
docker compose stop uptime-kuma
只有确认容器已经停止后,才使用组织批准的 Docker卷备份流程复制对应卷的完整内容。不要猜卷的实际名字:Compose项目名会影响它。可先只读核对挂载来源。
docker inspect "$(docker compose ps -a -q uptime-kuma)" \
  --format '{{range .Mounts}}{{if eq .Destination "/app/data"}}{{.Name}} {{.Source}}{{end}}{{end}}'
把数据备份、Compose文件与版本号一同存到访问受控的位置。备份可能含监控认证和通知密钥,不应上传到公开GitHub。备份完成后重启原实例,并复查正常基线与通知。不要执行会删除卷的清理操作。
docker compose start uptime-kuma
docker compose ps
docker compose logs --tail=80 uptime-kuma
恢复演练使用隔离环境,阻断对生产通知渠道的出站连接,防止两套探针重复发告警。若改用外部MariaDB,还须按数据库方案备份,不能声称单备份本地目录已覆盖全部数据。版本升级也应先有可恢复备份,不能直接把 v2 数据交回 v1 使用。
常见问题
页面总是200,为什么关键词监控还会失败?
响应体可能是维护页、登录页、代理错误页或不含业务标识的空壳。先看探针位置的原始响应,再检查状态码、跳转和标识。不要只看自己电脑的浏览器结果。
可以用它监控登录和下单吗?
单个HTTP关键词检查不能证明多步登录、浏览器脚本或交易正确性。对关键交易使用专门的合成事务和业务指标,同时避免测试产生真实订单或修改生产数据。
放在同一台服务器最省事,行不行?
可以用于试用和局部检测,但故障域相同。要覆盖服务器、出口或站点断网,需按目标故障域选择独立探针和监控探针自身的方式。
为什么不直接用latest标签?
官方列出的 latest 已废弃且指向v1;本例固定2.5.6。新版本是否适合,按官方发布说明、兼容性与维护窗口判断,不把“能拉取镜像”当成升级成功。
技术依据
Uptime Kuma 2.5.6 README、2.5.6监控实现、Docker Tags、v1到v2迁移与备份。本文为官方资料基础上的操作示例,不代表企业现场实施或完整交易实测。
相关解决方案
企业IT运维与值班支持适合梳理监控对象、探针位置和告警责任;业务连续性规划适合设计故障域与恢复演练。
相关阅读
如果企业已经有监控面板,却说不清哪个检查真正代表业务可用,可以从一个只读业务入口开始,核对探测条件、负责人和恢复消息,再决定是否扩展。