
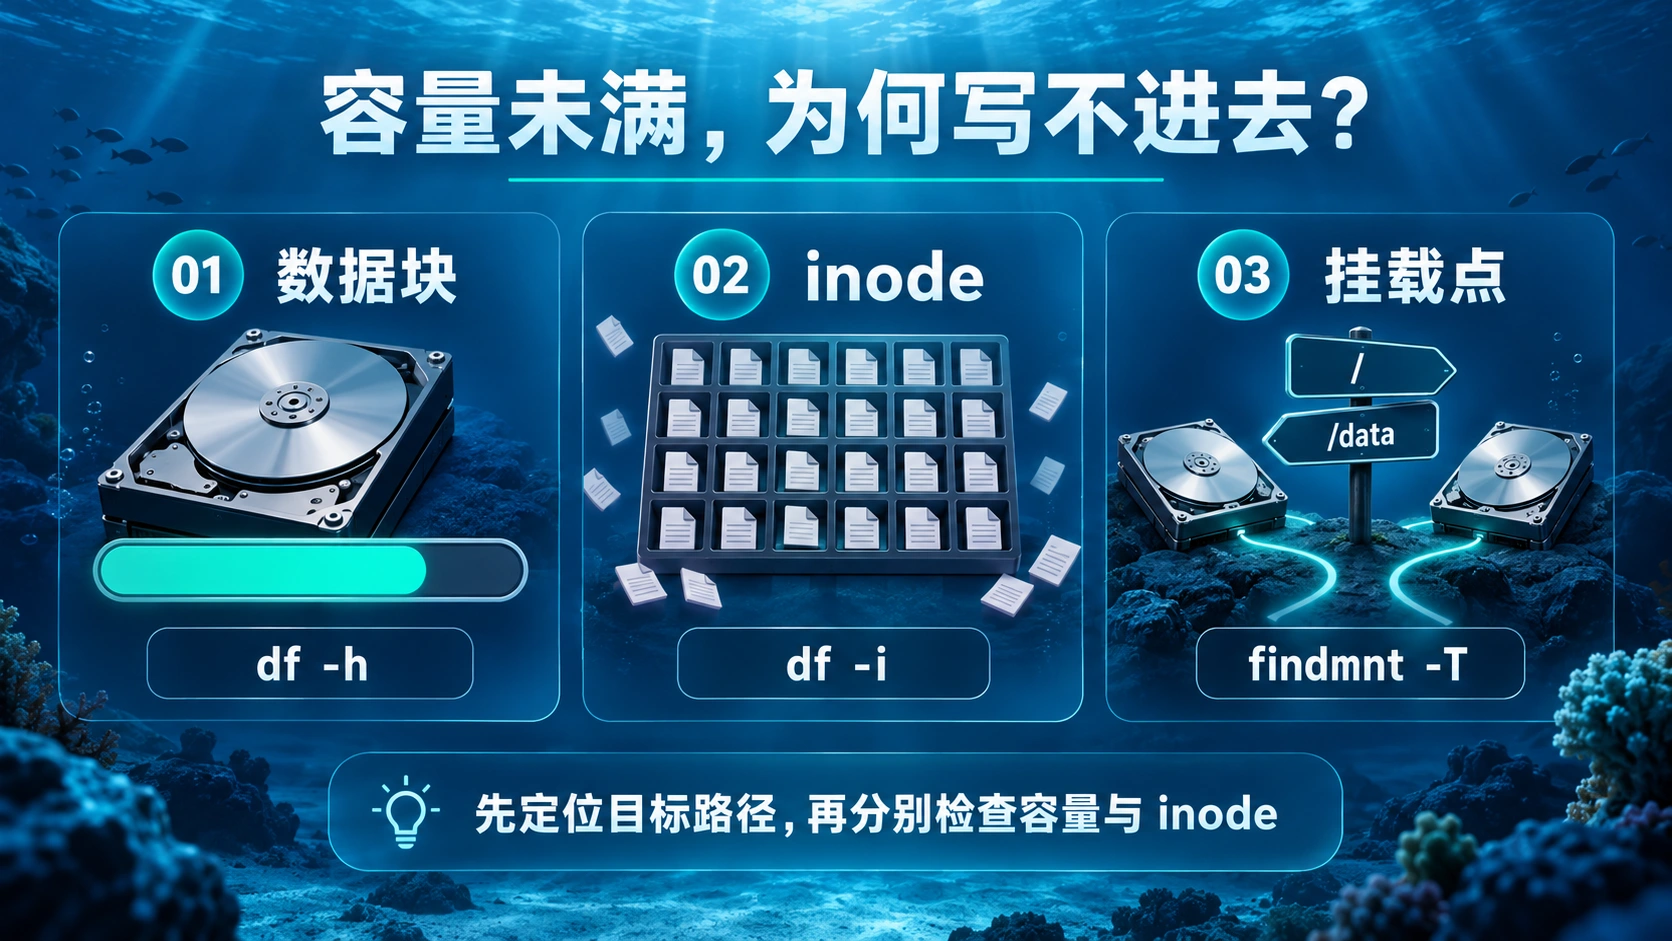
先检查报错路径所在的文件系统,再分别查看可用数据块与可用 inode。 inode 用尽时,即使还有 GB 级容量也可能无法创建文件;删除后仍被进程打开的文件会继续占用空间;数据盘未挂载时,应用还可能写进根分区。不能只凭另一块磁盘的使用率判断,也不能把所有写入失败都当成容量问题。
本文面向企业 Ubuntu 服务器的文件写入故障,先做只读定位,再决定变更。命令依据官方手册整理,为操作示例,未在本文客户现场执行;路径、账户和服务名必须替换为实际值。本文没有提供客户故障复现或修复成功的实测数据。
文章目录
适用环境与开始前要确认的事项第一步:对准真正失败的路径第二步:inode 耗尽时,找文件数量而非最大文件第三步:删除了文件,为什么空间没回来?第四步:数据盘没挂载,应用写到了根分区第五步:怎样证明恢复了,而不是暂时不报错?常见问题df 显示还有空间,为什么仍无法新建文件?删除一个最大的日志文件就能解决吗?要不要直接重启服务器?本文是否适用于 Docker 或 NFS?相关解决方案相关阅读适用环境与开始前要确认的事项
| 项目 | 本文范围与要求 |
|---|---|
| 系统 | 以 Ubuntu Server 22.04/24.04 LTS 常规虚拟机为例;26.04 LTS 须先核对本机工具帮助与包版本 |
| 文件系统 | 本地 ext4 为主要解释对象;容器 overlay、NFS、ZFS、Btrfs 与存储池故障需各自工具补充 |
| 工具 | GNU coreutils 的 df、du,util-linux 的 findmnt;已删除文件检查另需 lsof |
| 权限 | 普通用户可看容量;目录扫描与跨进程检查可能需要 sudo;写入复验使用原业务账户 |
| 变更前 | 有业务负责人、保留策略、可恢复备份及维护窗口;明确真实数据目录与预期挂载源 |
先保存应用原始错误、时间、失败动作和绝对路径。新建文件失败、已有文件追加失败、文件监听器创建失败,应分别判断。Linux 写入接口区分空间不足、配额不足、权限和只读等错误;应用日志有时将它们统一显示为“写入失败”。以原始错误为准。Ubuntu write 手册


第一步:对准真正失败的路径
以下示例假定应用向一个已经存在的数据目录写入。新文件尚不存在时,检查其最近的已有父目录;不要为了执行检查先创建新目录。
write_path='/srv/app-data'
findmnt --target "$write_path" --output TARGET,SOURCE,FSTYPE,OPTIONS
df -hT -- "$write_path"
df -i -- "$write_path"
查看挂载点、挂载源、文件系统类型与选项。对比部署记录中的设备 UUID 或挂载源:预期数据盘如果变成了根分区,就是挂载路径问题;出现只读选项则先处理只读原因。findmnt 的目标路径查询能找出承载该路径的文件系统;df 带路径参数也检查该路径所在文件系统。findmnt 官方发行版手册、GNU df 手册
| 看到什么 | 下一步 | 暂停条件 |
|---|---|---|
| IFree 为 0,容量仍有剩余 | 排查小文件和目录数量 | 不知道文件归属,不做删除 |
| Avail 接近 0,IFree 仍有余量 | 查占用及已删除打开文件 | 存储 I/O 错误或目录扫描异常 |
| 目标路径落在错误挂载源 | 核对数据盘和应用实际路径 | 不直接挂载覆盖正在写入的目录 |
| 两项都有余量且挂载正确 | 查配额、容器限制和准确错误 | 不凭猜测继续清理 |
若业务在容器或独立挂载命名空间中运行,应在相同运行环境检查其目标路径;宿主机相同字符串未必代表相同挂载。本文本机诊断结果不能直接证明容器可写。
第二步:inode 耗尽时,找文件数量而非最大文件
inode 保存文件所有者、权限及数据位置等元数据。ext4 的 inode 表在创建文件系统时分配,因此大量小文件可能先用尽 inode;这里的判断不能照搬到所有文件系统。Linux 内核 ext4 inode 文档、ext4 inode 表文档
先从已知应用目录向下查,避免在业务高峰扫描整个根目录。以下命令只统计,不删除;展示层级为一层,但统计仍会遍历子树,大目录会产生 I/O 负担。
sudo du --inodes -x --max-depth=1 -- "$write_path"
选择计数明显偏高的子目录,再将检查路径替换为该目录,逐层缩小范围。不要把 inode 统计简单理解为可删除文件清单;目录也需要元数据,硬链接计数也有自身规则。GNU du 的 inode 模式用于定位数量多的目录,单文件系统选项限制跨文件系统扫描。GNU du 手册
修复优先使用应用自己的缓存过期、队列归档或日志保留机制。实施前确认文件用途、保留期限、是否仍在使用,必要数据备份应位于另一个已验证的文件系统。业务数据库文件、消息队列未消费数据、备份仓库对象不属于可随意清除的缓存。所有权不明确、没有恢复方案、扫描使业务延迟明显上升时停止处理。
同一文件系统内移动文件通常不释放 inode。将大量文件打包到另一个文件系统也不是自动修复:必须核验归档可读取、权限和业务引用,再按批准策略处置原数据。长期反复耗尽时,评估应用对象数量、保留周期和迁移至适合该工作负载的独立文件系统;不要在原生产卷上重新格式化。
第三步:删除了文件,为什么空间没回来?
先比较同一范围的文件占用和文件系统容量,扫描必须覆盖相关目录且没有被忽略的权限错误。两者存在差异只是线索,也可能涉及挂载遮蔽或统计范围不同,不能据此直接认定已删除文件是唯一原因。
sudo du -x -h --max-depth=1 -- "$write_path"
sudo lsof -nP +L1
lsof 的链接数筛选会列出链接数小于 1 的打开文件。记录进程 PID、文件类型、设备、inode、文件描述符和路径,确认它位于故障文件系统。输出中的文件大小不总等于实际分配块数,同一 inode 也可能被多个描述符引用,不能直接相加。Ubuntu lsof 手册
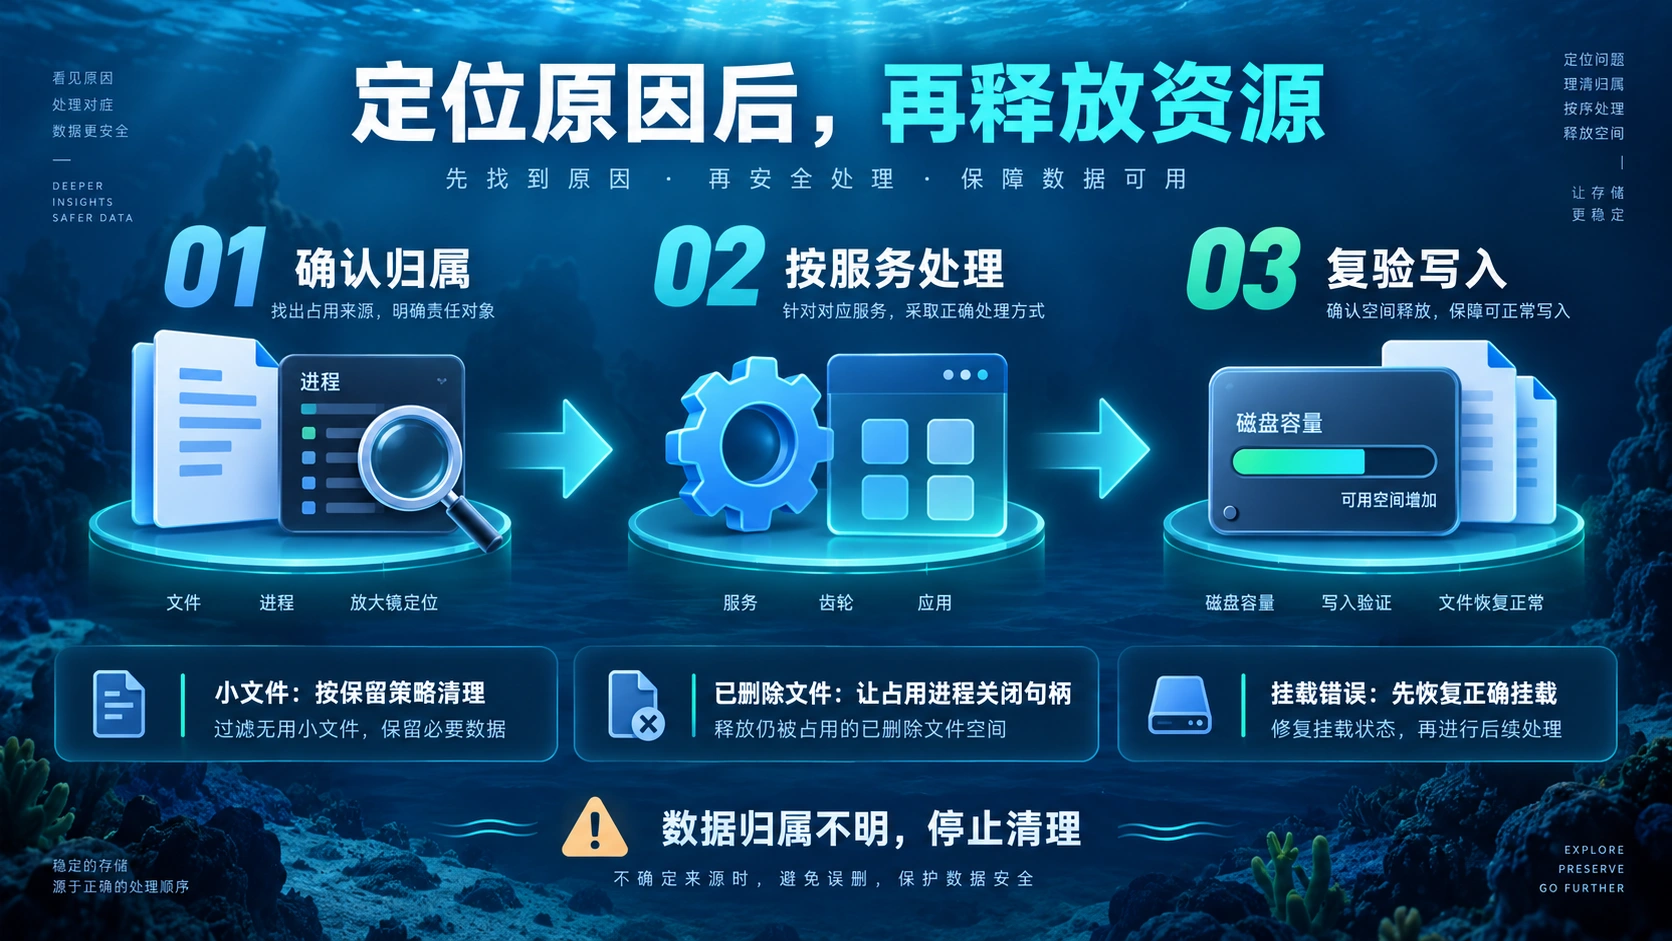
文件最后一个目录名称被删除后,如果进程仍持有它,文件会留到最后一个相关文件描述符关闭后才释放。继续删除路径无法让该进程自动关掉旧描述符。Ubuntu unlink 手册
修复应根据应用官方文档,让应用安全重开日志或关闭相关文件。不要假设每个服务 reload 都支持日志重开;systemd 的 reload 与重新读取 systemd 单元配置是不同动作。先检查目标服务能力与实际配置,示例服务名需替换:
systemctl show example.service --property=CanReload,ExecReload,MainPID
systemctl cat example.service
这两条只是读取信息,不执行重载。Ubuntu systemctl 手册
仅在应用文档明确支持、业务负责人认可且复验方法准备好后,才通过应用规定的动作释放描述符。数据库数据文件或无法辨认的文件直接交由该应用负责人处理;不向进程描述符写入截断数据,也不以强制结束进程或重启数据库试错。处理后重新查看 lsof 和 df,确认目标占用已变化,再测业务健康。
第四步:数据盘没挂载,应用写到了根分区
如果第一步显示挂载源不符合部署记录,先暂停新增业务写入,保留当前目录数据并核对设备、UUID、挂载配置和最近变更。挂载之前已有文件可能位于根分区目录;直接把数据盘挂上去会遮蔽这些文件,并可能让应用突然看到另一套数据。
恢复前要回答三个问题:哪个数据集是最新且可用的、应用应该使用哪块卷、迁移或同步如何回退。在维护窗口按确认后的方案恢复挂载与应用路径,再核对业务账户、目录权限和文件内容。遇到设备失联、文件系统只读、I/O 错误或两套业务数据不一致时停止,转存储恢复流程;不在业务仍使用的卷上运行离线修复工具。
涉及数据迁移时,可先参考指定目录恢复与完整性验证制定抽样或逐文件核对方法。它解决恢复验收问题,不替代本次挂载源判断。
第五步:怎样证明恢复了,而不是暂时不报错?
容量与 inode 检查先复跑。随后使用真实业务账户,在负责人批准的目标测试目录创建、写入、同步并读取一个小文件,再删除这个专用测试文件。下面是受控探针示例;必须在业务目录允许临时文件、业务不监听该文件名时使用,不得在数据库目录直接执行。
write_path='/srv/app-data'
probe=$(mktemp "$write_path/.yuqi-write-probe.XXXXXX") || exit 1
if printf '%s\n' 'write-probe' > "$probe" && sync -f "$probe" && cat -- "$probe"; then
  rm -- "$probe"
else
  printf 'Write probe failed; inspect the retained file: %s\n' "$probe" >&2
  exit 1
fi
探针中的同步动作会请求同步该文件所在文件系统的待处理 I/O,并非只刷新这个小文件;繁忙文件系统应在批准窗口执行。GNU sync 官方手册
该探针只删除本次随机创建的测试文件;失败时保留路径供检查。预期读取出探针文本,且写入、同步与读取均成功。一次成功只证明该账户、该路径、该时刻的小文件操作,不能证明大文件、数据库事务或长时间写入安全。随后执行应用自身健康检查和一条真实业务写入链路,核对日志无新增同类错误。
| 验收项 | 接受条件 |
|---|---|
| 路径 | 挂载源、文件系统与部署设计一致 |
| 资源 | 数据块和 inode 均有覆盖下一维护窗口预计增长的余量 |
| 文件占用 | 涉及的已删除打开文件已释放,或已有明确且受控的保留原因 |
| 业务 | 原账户能完成受控探针,真实业务链路成功,日志没有持续新增错误 |
| 观察 | 覆盖至少一个典型批处理或日志轮转周期,资源增长速率可解释 |
监控不要只看容量百分比,还应加入 inode 使用率、可用量与增长速率,并指定告警接收人和停止写入门槛。阈值要按业务增长与响应时间设计,可参考服务器磁盘容量告警与验收。
常见问题
df 显示还有空间,为什么仍无法新建文件?
先确认检查的是报错路径,再查看 inode 余量。若两者充足,继续核对应用运行环境、配额与原始错误;权限拒绝和只读错误需要不同处理,不应继续清理文件。
删除一个最大的日志文件就能解决吗?
inode 耗尽时,大文件大小与可释放的 inode 数量不是同一指标;文件仍被打开时,删除名称也可能暂时不回收占用。先查资源类型和进程引用。
要不要直接重启服务器?
不把整机重启作为首个诊断步骤。它会中断业务且改变进程证据;应先确认根因和应用恢复动作。若确需维护重启,先建立业务恢复与回退方案。
本文是否适用于 Docker 或 NFS?
只读工具能提供部分线索,但必须检查应用实际命名空间、容器存储驱动或远端服务配额。本文不覆盖这些系统的完整修复,也不建议套用本地 ext4 的结论。
相关解决方案
服务器与存储方案:将数据卷规划、业务恢复与容量告警纳入交付范围,实施边界需按实际环境确认。
相关阅读
如果需要梳理企业服务器的数据路径与恢复门槛,可带上脱敏后的报错时间、挂载信息和容量统计,与煜企讨论检查范围。