
监控群里每天都有红点,真正需要追问时,却常常没人能马上回答:这是哪个业务的影响?谁先接手?第一步做什么?什么时候算处理完成?
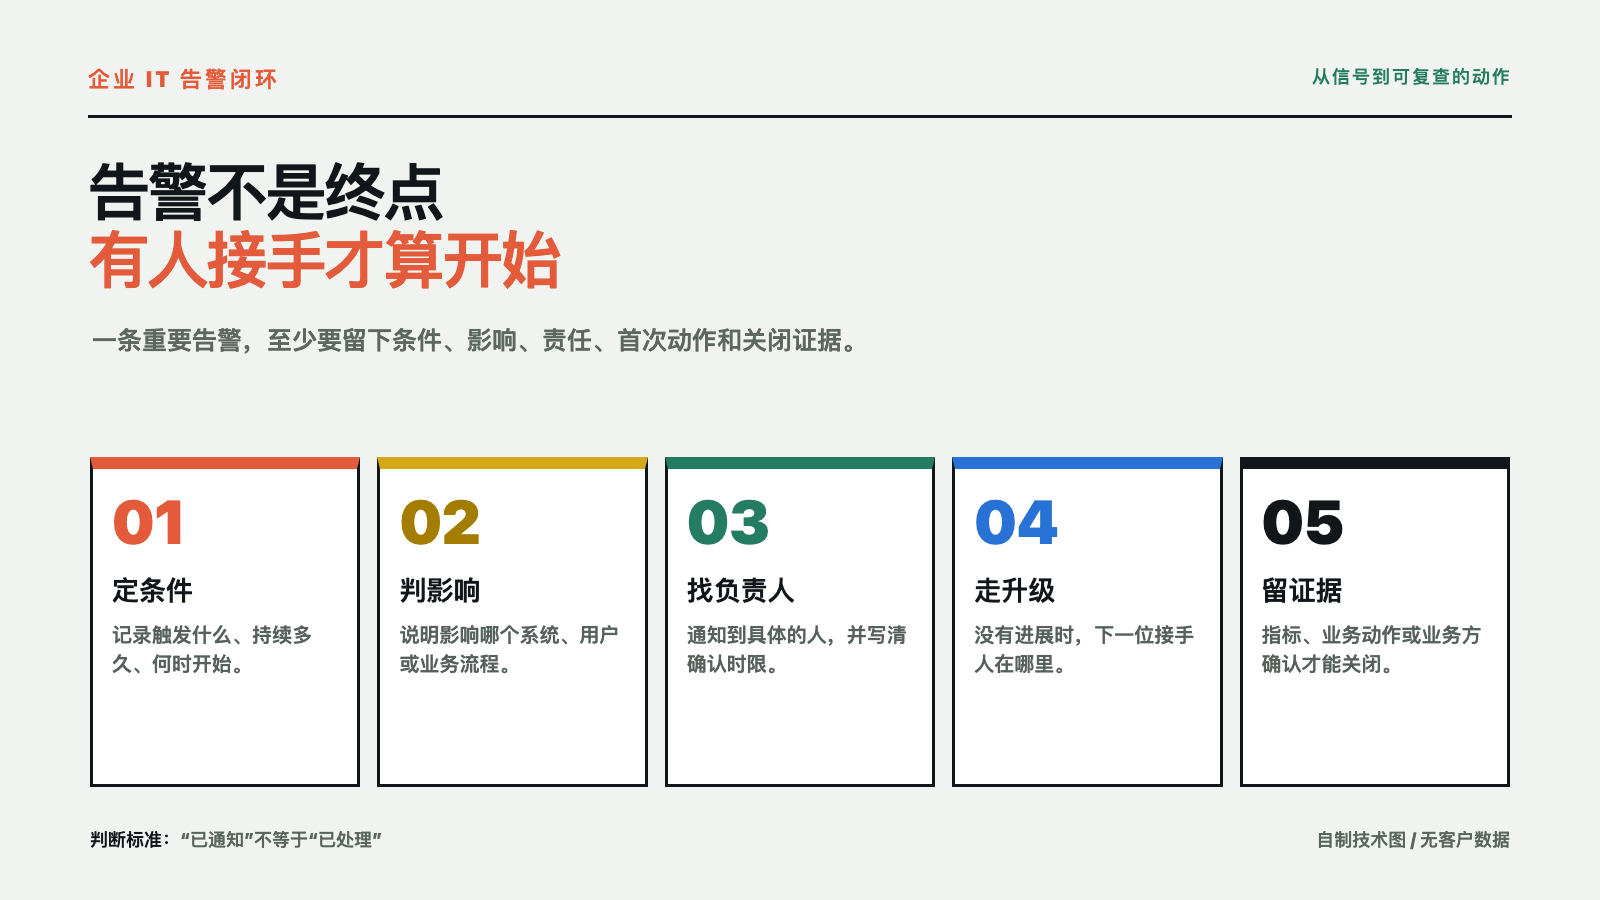
“系统发出了告警”只说明某个条件被触发,不等于动作已经发生。没有责任人、处理渠道、升级路径和关闭证据,告警越多,越容易被当成背景噪声。企业 IT 告警闭环要解决的不是让屏幕变得更红,而是让每个需要关注的信号都能走到一个可复查的结果。
先区分“信号”与“需要动作的事件”
不是每一条监控信号都应该立即叫醒一个人。先把信号分成三类:只需要记录的观察项、需要在工作时间处理的风险项、需要立即响应的业务影响项。分级依据应当来自业务影响和可接受的恢复时间,而不是单纯看颜色或阈值大小。
例如,同一个接口延迟升高,如果没有用户影响、持续时间很短,可能只需要记录;如果已经影响登录、订单或内部协作,就需要明确负责人和首次动作。这里不预设某个产品的阈值,也不把示例当成客户现场的实测规则。企业应按自身业务、依赖关系和维护窗口定义条件。
每条重要告警至少留下九个字段
第一,记录触发条件:监控检查了什么,连续多久,何时开始。第二,写清业务影响:影响哪个系统、用户或关键流程,当前是否仍在扩大。第三,标出等级:观察、工作时间处理,还是需要立即响应,并说明依据。
第四,指定负责人,而不是只写一个部门名称。第五,规定通知渠道和确认动作:发到哪里,多久没有确认就升级。第六,写出首次动作:查看哪项日志、确认哪个依赖、暂停哪个变更,或者先保护哪份数据。
第七,准备升级路径:负责人无响应时交给谁,涉及网络、应用、供应商或业务方时怎样转交。第八,定义关闭证据:指标恢复、业务动作通过、变更已回退,还是业务负责人确认影响结束。第九,留下复盘日期和结论:是否需要调整阈值、去重规则、容量、权限或运行手册。
这九个字段不要求一开始就做成复杂平台。先用一张共享表或服务台字段跑通一周,也比把所有告警继续堆在聊天窗口里更容易发现缺口。
用三层动作把闭环跑起来
第一层:减少噪声,但不隐藏风险
把同一根因造成的重复通知合并,设置合理的抑制、冷却和维护窗口;同时保留原始事件,避免为了“少响一点”把真正的影响一起吞掉。每一条被合并的告警,都要能追溯到原始条件和合并理由。
第二层:从部门名改成具体认领
告警通知里至少要有系统、影响、等级、负责人、首次动作和确认时限。Azure Monitor 官方文档把告警规则与 action group、通知和动作连接起来,并提供测试 action group 的路径;这说明“触发条件”和“通知动作”是两个需要分别设计和验证的环节,不是配置一次就自动形成责任制。
第三层:把关闭写成证据
“已经处理”“应该恢复了”都不是足够的关闭记录。关闭时至少附一项可复查证据:指标恢复到什么范围、哪个业务动作重新成功、哪次变更完成回退、谁确认影响结束。对无法验证的事件,状态可以写“缓解完成、根因待查”,不要为了让列表变绿而提前关闭。
一次小范围演练怎么开始
不要一上来改全套监控。先挑一种真实存在、但影响范围可控的告警,补齐九个字段,指定一个工作时段做演练:触发或回放事件,确认通知是否到达;由负责人认领并记录首次动作;如果在约定时间内没有进展,走一次升级;最后让业务或系统使用者完成一个最小验证动作。
演练结束只回答四个问题:告警有没有到对的人?对方是否知道第一步?升级是否真的能找到下一位?关闭时有没有业务可理解的证据?任何一项答不上来,都应该记录为闭环缺口,而不是写成“监控已完善”。
什么时候不要急着加更多监控
如果现有告警没有负责人、没有维护窗口、没有必要权限、没有服务依赖图,或者业务方从未参与验收,继续增加规则往往只会增加噪声。Google SRE 的企业路线资料把“对原因告警、却没有明确用户可感知症状”列为需要警惕的模式;NIST 的事件响应指南也把检测、分析、响应和复盘放在同一条处理链上。监控不是终点,能否让人采取正确动作才是运维流程的价值。
煜企能承接什么
煜企可以围绕企业现有的服务器、网络、虚拟化和应用环境,协助梳理告警分类、责任边界、通知与升级路径、值守记录、变更关联和关闭验收,整理成可交接的 IT 运维文档与执行流程。具体范围要以现有系统、人员权限、业务影响和双方确认的服务边界为准,不承诺零告警、固定响应时间或所有事件自动解决。
如果你要先判断“告警为什么总是没人接”,可以查看煜企企业 IT 运维与基础设施托管服务,从一类告警和一张九字段表开始,而不是先采购更多监控工具。
资料来源:Microsoft Azure Monitor Action groups、Create a metric alert、NIST Computer Security Incident Handling Guide 和 Google SRE Enterprise Roadmap。本文是一般性企业 IT 规划信息,不构成具体监控配置、事故响应审计或服务承诺;没有客户实测数据或厂商背书。
九字段告警闭环记录表
沿用前文九个字段,不增加一套新的工单口径。先选一种影响可控的告警,按表记录通知、认领、升级和业务验证;字段内容由本企业的系统与服务边界确定。
| 字段 | 需要回答的问题 | 记录或证据 |
|---|---|---|
| 触发条件 | 检查什么、持续多久、何时开始? | 原始事件编号、指标或日志时间范围。 |
| 业务影响 | 影响哪个系统、用户或关键动作,是否仍在扩大? | 受影响服务与已验证症状,未知项明确标注。 |
| 等级 | 观察、工作时间处理还是立即响应,依据是什么? | 事件等级、分级依据与调整记录。 |
| 负责人 | 谁负责接手,谁可以替补? | 具体认领人、确认时间与替补联系人。 |
| 通知与确认 | 发到哪里,未确认时何时升级? | 通知回执、认领记录与约定确认时限。 |
| 首次动作 | 先查哪项日志或依赖,需要停止什么变更? | 已执行动作、结果与所用权限。 |
| 升级路径 | 无响应或跨团队时由谁接下一步? | 转交对象、升级时间与接手回执。 |
| 关闭证据 | 哪个业务动作恢复,哪些问题仍未解决? | 指标、业务回执或回退记录;区分缓解与根因关闭。 |
| 复盘与结论 | 是否需要调整阈值、去重、容量或运行手册? | 复盘日期、整改责任人、复测条件与结果。 |
用一条事件验证整条处理链
检查四件事:通知是否到对的人、对方是否知道第一步、升级是否能找到下一位、关闭是否有业务可理解的证据。任何一项缺失都保留为闭环缺口;不要通过删除原始事件或过早关闭来让列表变绿。
这是流程记录模板,不是具体产品阈值、统一响应时限或客户现场结果。