YUQI / WEB DATA PIPELINE · 基于 Firecrawl 二次开发方案
把网页,整理成
可持续更新的数据源
从网址清单到整站抓取,从正文提取到 Markdown / JSON 交付。煜企智能把分散在官网、文档站、产品目录与公告页里的内容,做成可复核、可复跑、可对接的结构化数据。
逐项核对
Markdown / JSON
来源 → 交付
云 / 自建 / 混合
01 / 目标网址(演示样例)
02 / 采集范围
03 / 输出格式
# 产品说明(演示样例)
等待运行演示流程后,此处展示模拟的正文抽取结果。
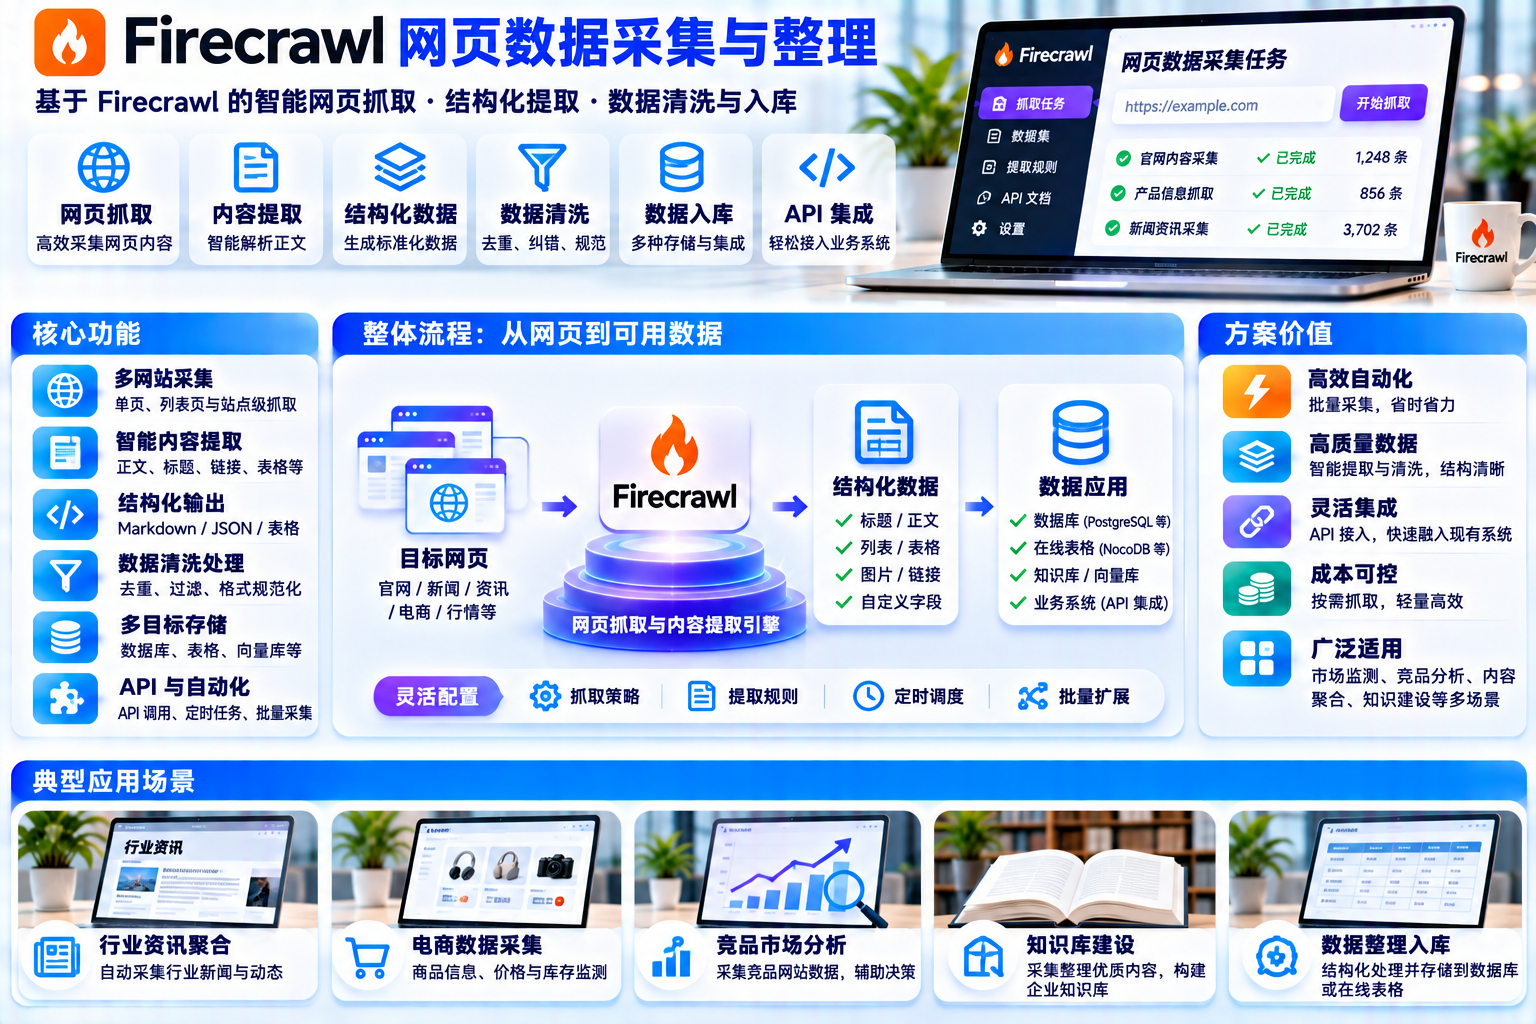
图中的界面、数据及价格为示例;实际功能、授权与交付范围按项目确认。
01 / CAPABILITY MAP · 已核对官方资料
哪些是引擎原生,哪些需要定制实施
煜企智能以 Firecrawl 作为采集与提取引擎。以下按官方资料区分采集引擎与定制层,实际功能取决于版本、部署路径和外部服务配置。把两者分清,是评估工作量与交付边界的前提。
单页抓取 Scrape
任意 URL 转 Markdown、HTML、截图或结构化 JSON;可只取正文内容。
官方能力整站抓取 Crawl
通过 sitemap 与递归链接发现页面,支持 limit、maxDiscoveryDepth、路径包含与排除。
官方能力网址发现 Map
快速枚举站点 URL,用于在正式抓取前确认范围与清单。
官方能力批量异步 Batch
数千个网址异步抓取,配合状态查询获取结果。
官方能力正文与格式输出
Markdown / HTML 输出,以及按 schema 的结构化 JSON 抽取。
官方能力任务状态与回调
状态轮询、watcher 与 webhook(started / page / completed,HMAC 签名)。
官方能力搜索与结果提取
Search 可配合抓取输出结果内容;搜索供应商与自托管配置需逐项核验。
配置后使用模型辅助结构化
按 schema 提取 JSON;模型供应商、文件解析与高级提取路径按所选部署配置。
按配置核验站点清洗规则
按客户站点定义正文选择器,剔除导航、页脚、广告与模板噪声。
需定制内容级去重
按业务定义内容哈希、相似度阈值与 canonical 合并策略,并保留人工复核。
需定制定时增量更新
调度周期、变更检测、只重采变化页,形成可持续更新的数据源。
需定制数据质量校验
字段完备性、空值与异常页复核,输出可复查的质检结果。
需定制任务编排与审计
运行台账、失败重试、留存策略与权限记录,便于追溯每次交付。
需定制交付打包与版本
Markdown / JSON 目录结构、导出规范、版本快照与差异清单。
需定制下游系统对接
写入接口、字段映射与分块元数据约定;知识库写入后的检索能力另建。
需定制合规与访问控制
robots.txt 与站点条款核对、白名单、采集频率与访问审计。
需定制ignoreQueryParameters 仅避免同一路径不同查询参数被重复抓取,不属于内容级去重;官方亦提示「抓取任务完成不等于覆盖到每一页」。因此清洗规则、内容去重与定时增量更新均属于定制实施范围。
02 / DATA PIPELINE · 链路可视化
网页来源 → 采集提取 → 清洗整理 → 交付或对接
四段链路各自留有可核对的输入与输出。前两段主要由采集引擎完成,第三段是按站点规则实施的定制层,第四段决定数据交给谁、以什么格式、多久更新一次。
网页来源
确定采什么、不采什么:网址清单、域名范围、路径包含与排除规则、更新频率与合规前提。
采集提取
单页、整站或批量网址抓取;JS 渲染页面可取回正文,输出 Markdown / HTML,或按 schema 抽取结构化 JSON。
清洗整理
剔除导航、页脚与广告噪声;按内容哈希或相似度去重;字段完备性校验;标记新增与变更页,形成可增量更新的数据集。
交付数据 / 对接知识库
交付 Markdown / JSON 数据包与任务台账;也可按约定写入下游系统。知识库建设本身不在此段内。
采集与整理产出的是「可用语料 / 数据源」。要让这些数据可被检索问答,还需要另行完成右侧工作。
范围声明本页介绍的服务范围(采集与整理)
需另行建设(RAG 知识库侧)
RAG DATA READINESS · 数据准备
为知识库准备语料,但不替它建库
面向后续知识库建设,我们把语料整理到「可直接接收」的程度。以下六项是本方案交付的数据准备内容,仍属于采集与整理范围。
来源可追溯
每条数据附 source_url、站点标识与采集时间,便于引用与回溯。
正文粒度
去噪后的 Markdown 保留标题层级,适合后续按语义切分。
结构化字段
JSON 字段(名称、SKU、参数、更新时间)可直接作为检索元数据。
去重与版本
重复页合并并保留版本标记,避免同一内容反复入库。
增量变更标记
标注新增 / 变更 / 失效页,支持按批次更新语料。
交付契约
目录规范、批次编号与写入接口约定,便于下游系统接收。
03 / PRODUCT SURFACE · 界面演示
客户日常看到的,是任务、输出与规则
下列四个视图均为前端模拟:任务记录可筛选、输出格式可切换、清洗规则可开关。目的是说明交付物长什么样,不代表本页连接了任何真实服务或数据库。
| 任务 ID | 来源(演示域名) | 采集模式 | 页数 | 输出 | 状态 | 时间 |
|---|
# 采集前的原始页面噪声(示意)
首页  产品  文档  价格  登录  ▸
## PX-200 工业网关 产品说明
PX-200 支持双链路冗余与远程运维…
推荐阅读|相关产品|版权所有 ©
广告位 / 面包屑 / 页脚导航 / Cookie 提示
# PX-200 工业网关
"category": "网络设备"
"sku": "PX-200"

## 关键参数
- 双链路冗余切换:< 200 ms
- 工作温度:-20 ~ 65 ℃
- 远程运维:支持

--- source: docs.example.com/product/px-200
--- crawled_at: 2026-11-15 09:42(演示)
{
  "type": "object",
  "properties": {
    "product_name": { "type": "string" },
    "sku":          { "type": "string" },
    "specs":        { "type": "array" },
    "updated_at":   { "type": "string" }
  }
}
{
  "product_name": "PX-200 工业网关",
  "sku": "PX-200",
  "specs": [
    "双链路冗余 < 200 ms",
    "工作温度 -20 ~ 65 ℃"
  ],
  "source_url": "docs.example.com/…",
  "updated_at": "演示时间"
}
04 / DEPLOYMENT · 部署方式
三种落地路径,按数据边界选择
部署方式决定数据经过哪里、由谁运维、以及许可义务如何履行。以下为方案选项,本页不包含任何实际部署动作。
Firecrawl Cloud 托管服务
使用官方托管 API 与 API Key 完成抓取,起步快、无需自建基础设施;Cloud 版还包含开源版没有的额外能力。
- 适合:快速验证、来源分散、并发波动大
- 数据路径:经第三方服务处理
- 代价:按用量计费,需评估数据出域
自建 Docker Compose 私有化
按官方 SELF_HOST.md / docker-compose.yaml 在客户环境运行开源版,采集与中间数据可按方案存储在客户环境,外部站点、模型与代理的数据流须另行确认;队列与数据库等组件由客户侧运维。
- 适合:需要基础设施控制、有运维能力
- 官方组件:API / Worker / PostgreSQL(NuQ) 等
- 代价:版本升级、扩容与监控自担
混合分层:采集与入库解耦
抓取与提取按需选择云端或自建,清洗、去重、任务台账与交付在客户侧完成,便于后续替换任一环节。
- 适合:已有数据平台、希望逐步替换
- 边界:清洗与调度逻辑归属明确
- 代价:需要定义清晰的接口与数据契约
AGPL-3.0,SDK 与部分 UI 组件为 MIT;官方自托管入口为 SELF_HOST.md、docker-compose.yaml 与 Self-Hosting Guide,具体组件与环境变量以官方指南为准(本页不展开未经核实的部署参数)。
Firecrawl 默认遵守 robots.txt,官方同时提示「最终用户有责任遵守站点政策、隐私政策与使用条款」。若自建并对外提供网络服务,AGPL-3.0 相关义务应交由法务评估;本页不构成法律意见。
05 / DELIVERABLES · 交付成果
交付的是可复跑的数据资产,不是一次性文件
每一项都有对应的可核对物:来源可追溯、规则可修改、任务可复查、更新可计划。拟交付范围以双方确认的实施与验收清单为准。
来源清单与采集配置
网址清单、域名范围、路径包含 / 排除规则、采集频率约定。
站点清洗规则说明
正文选择器、噪声剔除项、字段映射与例外处理清单。
结构化数据集
Markdown 正文与 JSON 字段数据,附来源 URL 与采集时间。
去重与质检结果
重复页判定、变更页清单与待复核项,便于抽检。
任务记录与运行日志
每次任务的状态、页数、失败原因与重跑记录。
更新与对接方案
增量更新计划、交付目录规范与下游写入接口约定。
06 / WORK SCENARIOS · 使用场景
从「谁去复制粘贴」到「数据自己更新」
典型起点是:产品资料散落在官网与文档站、竞品与公告页需要定期汇总、内部知识库长期缺少新鲜语料。下列为真实场景配图,用于说明协作情境。
确认哪些页面要采、哪些路径排除、多久更新一次,先把规则说清再跑任务。
对噪声页、重复内容与字段缺失做抽检,把例外沉淀成新的清洗规则。
按约定格式交付数据包与任务台账,或把数据送入客户指定的系统。
让新增与变更页按计划进入数据集,减少重复的人工整理;更新策略本身属于定制实施范围。
07 / VALUE · 减少手工整理
把重复劳动,换成可维护的数据流程
下表说明工作方式的变化。收益来自流程化与可复跑,而不是某个工具的宣称指标;具体效果取决于站点结构、页面质量与约定的更新频率。