
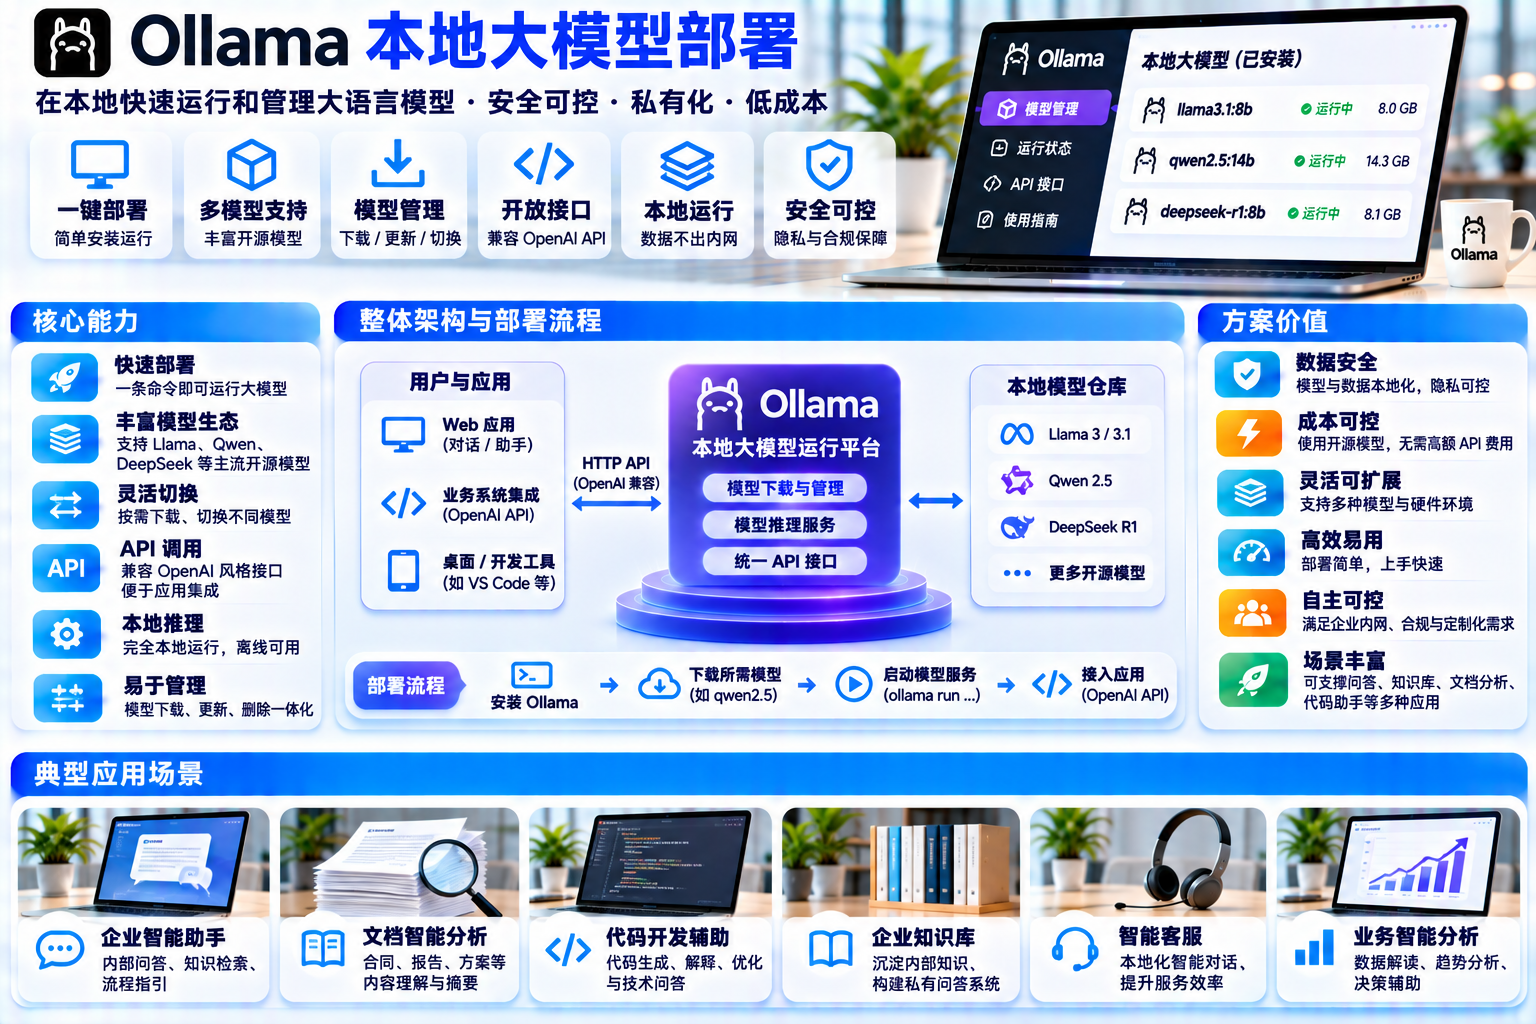
图中的界面、数据及价格为示例;实际功能、授权与交付范围按项目确认。
客户拿到什么,Ollama 给什么,我们补什么
部署一套本地推理服务,和「建成企业 AI 平台」不是同一件事。下面把三者的责任分开列明——这是评估工作量、许可与后续运维的前提。
一套可运行的私有推理能力
- 部署在自有环境的 Ollama 服务,含模型文件、启动配置与运行账号
- 企业对话入口:统一登录后的问答界面、模型切换与会话记录
- 标准模型 API:原生 REST 与 OpenAI 兼容端点,供业务系统调用
- 模型清单与运维手册:版本、来源、权重许可、升级与回滚步骤
- 测试报告与交付文档:功能验证、异常处置、监控与交接清单
模型运行与推理底座
- 模型拉取与运行:ollama pull / run / ps,本地权重存储
- REST API:/api/chat、/api/tags 等,支持流式返回
- OpenAI 兼容层:/v1/chat/completions(官方称支持 API 子集)
- 调度与显存管理:并发队列、多模型加载、GPU/CPU 分配、上下文长度配置
- 模型定义:Modelfile 定制参数、量化版本管理、官方 Python / JS SDK
把它变成企业能用的系统
- 账号、组织与权限:统一认证、角色、模型可见范围与配额
- 知识库与检索:文档解析、切片、向量库、RAG 编排与引用溯源
- 审计与合规:提问/回答留痕、敏感词策略、导出与留存周期
- 多用户与并发治理:会话隔离、限流、排队提示、用量统计
- 业务系统集成与运维:接口适配、反向代理与 TLS、监控告警、备份
※ Ollama 官方文档未列出内置的企业账号体系、角色权限、审计日志或知识库模块;本页不把「部署模型」表述为「建成企业 AI 平台」。所有界面与描述均为方案示意 · 演示。
一端是机房里的算力,一端是日常办公
本地部署的价值不在界面,而在推理发生在哪台机器、由谁访问、接到哪个业务环节。以下为场景配图,非煜企或客户现场实拍。
用户入口 → 应用与访问控制 → Ollama 推理服务 → 模型与算力
点击任一层查看该层「底座原生能力」与「煜企定制开发」的分界。青色代表 Ollama 原生提供,琥珀色代表需要额外开发。
用户入口
员工、业务系统、内部应用发起对话或 API 调用;入口形式决定后续的权限与审计设计。
企业应用/访问控制
鉴权、角色、配额、会话与审计;把 Ollama 的本地端口收敛到可管理的应用网关之后。
Ollama 推理服务
接收请求、排队与调度、加载模型、流式生成并返回;默认只监听本机 127.0.0.1:11434。
模型与算力
本地权重文件、量化版本与权重许可;CPU / GPU 显存、上下文长度与并发共同决定能否加载。
从提问到返回,逐节点点亮
点击「发起演示请求」查看一次调用的完整链路。节点、日志与顺序均为演示模拟,用于说明责任分区,不代表真实耗时或真实性能。
模型管理:版本、许可与运行状态放在一张表里
切换标签、搜索、选中模型行并试一次「加载/卸载」。表中文件大小取自 Ollama 官方模型页公开信息,非本方案实测;状态与操作全部为演示。
| MODEL | 参数 | 文件大小 | 权重许可 | 状态 |
|---|---|---|---|---|
| qwen3:8b | 8B | 5.2GB | Apache 2.0 | 未加载 |
| llama3.1:8b | 8B | 4.9GB | Meta 社区许可 | 未加载 |
| deepseek-r1:8b | 8B | 5.2GB | 权重 MIT* | 已加载 |
| gemma3:4b | 4B | 3.4GB | Gemma Terms | 未加载 |
官方模型页给出各 tag 的下载体积(如 8B 级约 4.9–5.2GB、70B 级约 43GB、671B 级约 404GB)。实际显存还需覆盖 KV cache 与上下文,不能只看文件大小。
官方 FAQ:并行请求会按 OLLAMA_NUM_PARALLEL × 上下文长度放大内存;FAQ 给出默认上下文 4096 tokens,实际以所选版本和配置为准,资源不足时可能排队,CPU/GPU分配以配置为准。
官方 GPU 文档列明 NVIDIA 计算能力 5.0+(驱动 550+,部分需 570+)、AMD ROCm v7、Apple Metal、Vulkan。需在目标机器上逐项验证。
※ 本页不提供 tokens/s、响应时延、并发上限等性能数据,也不给出通用硬件配置结论;选型以目标模型、目标并发和实机验证为准。
两种接入方式,一个本地端口
下面的命令与代码结构来自 Ollama 官方文档。切换标签查看原生 REST、OpenAI 兼容端点与 CLI;参数为示意,不构成性能或安全承诺。
curl http://localhost:11434/api/tags
本地端口与默认绑定
官方 FAQ:Ollama 默认绑定 127.0.0.1:11434;如需被其他主机访问,要显式设置 OLLAMA_HOST,并自行加反向代理、TLS 与访问控制。
本地端点默认不要求鉴权
官方 OpenAI 兼容文档写明,本地调用时 api_key 是「required but ignored」。不要把 11434 直接暴露到办公网或公网;认证需在网关与服务端强制执行,不能只依靠前端界面。
兼容层是「子集」
官方原文:"Ollama supports a subset of the OpenAI API"。已有 SDK 可改 base_url 复用,但依赖完整 OpenAI 语义的功能需要逐项验证,不能默认全兼容。
模型能力要落到业务动作上
Ollama 提供推理接口,不提供这些业务系统的连接器。以下六类集成点都需要煜企按现有系统做接口适配、权限映射与异常处置。
内部文档与知识
制度、手册、合同模板的检索问答。文档解析、切片、向量库与引用溯源需定制开发。
工单与客服
在既有工单系统里生成回复建议、归类与摘要;需对接现有接口与权限模型。
表格与 ERP
把自然语言查询映射到受控的数据查询,输出前做权限校验,避免越权读取。
研发与代码
代码补全、评审提示与内部规范问答;需结合代码仓库权限与敏感信息策略。
报表与 BI
为既有看板生成解读文字;数据源不变,只增加一层受控的模型调用。
门户与 IM
在门户、企业 IM 中提供统一入口;账号、会话与消息审计需统一设计。
哪些是底座自带,哪些必须另外做
这是本页最重要的一张对照。左栏是可直接使用的底座能力;右栏常被误认为「部署完就有」,实际需要单独设计、开发与验收。
底座能力 · Ollama 原生
依据官方 README / API / FAQ / GPU 文档
额外开发 · 煜企交付范围
官方未将下列能力列为内置模块
六个阶段,每阶段都有可验收的产出
流程为方案示意 · 演示,不代表具体项目的排期、报价或承诺。硬件与模型结论都以实机验证为准。
硬件评估
按目标模型体积、上下文长度、并发数与 GPU 兼容性逐项核对,形成实机验证记录。
输出:硬件核对表部署
在自有环境安装 Ollama,配置运行账号、模型存储路径、绑定地址与网络策略。
输出:部署配置模型选型
按场景比较候选模型,逐个 tag 核对权重许可、量化版本与上下文能力。
输出:模型清单 + 许可记录接口集成
实现对话入口、应用网关、认证权限与业务系统接口适配,按需接入知识库。
输出:可运行的应用测试
验证功能链路、并发与排队行为、异常处置、权限边界与网络出口策略。
输出:测试报告运维交付
交接监控告警、日志与审计、备份、升级回滚流程及运维手册。
输出:运维手册 + 验收清单
引擎是 MIT,模型权重各有各的许可
Ollama 的软件许可与模型权重许可相互独立。以下结论核对自官方仓库、官方模型页与许可原文(2026-11-15);商用前须对实际选用的每一个 tag 再核对一次。
官方 LICENSE 原文 "MIT License · Copyright (c) Ollama":允许使用、复制、修改、分发、再许可与销售,须保留版权与许可声明,按 "AS IS" 提供、无担保。该许可不覆盖模型权重。
QwenLM/Qwen3 README 原文 "All our open-weight models are licensed under Apache 2.0.",并提示在各 Hugging Face 仓库查看许可文件。
LLAMA 3.1 COMMUNITY LICENSE AGREEMENT:非标准开源许可,含 700M 月活附加条款、须遵守 AUP、分发时标注 "Built with Llama" 并保留 Notice。
官方模型页写明权重为 MIT;蒸馏版同时核对其实际基座、模型卡及许可,同一家族不同 tag 可能不同,必须逐个核对。
官方模型页引用 Google 的 Gemma Terms of Use,属于自有使用条款,不是 Apache 2.0 或 MIT。
关于「离线」与「数据不外发」:不做笼统承诺
- 远端拉取需联网,离线预置另行设计官方 FAQ 原文 "Ollama pulls models from the Internet",从远端仓库 pull 与更新时涉及外部连接;通过受控介质预置模型需另行规划来源、完整性和许可。
- 默认只监听本机官方 FAQ 原文 "Ollama binds 127.0.0.1 port 11434 by default",跨机访问需 OLLAMA_HOST 与额外的网络策略。
- 本地模式 ≠ 绝对断网`OLLAMA_NO_CLOUD=1` 关闭的是 cloud models 与 web search;官方未声明该模式阻断全部外部请求。
- 云功能会改变数据路径官方说明使用 cloud-hosted models 时会处理 prompts/responses,并收集有限用量元数据(不含 prompt/response 内容)。
- 第三方组件需单独评估业务集成、监控、更新检查、DNS、日志外送与插件都可能产生外部连接。
- 交付时逐项核对网络策略、出口白名单、云功能开关、日志留存与模型来源应写进验收清单,而非用一句「完全离线」代替。
→ 这两句描述的是本地运行与云功能开关,不构成「任何情况下数据绝不外发」的承诺。
※ 本页不含客户案例、经营成绩、tokens/s 或响应时延等性能数据;所有界面、回答、指标、日志与流程均标注「演示」。
先把边界、许可和硬件算清楚
一个可落地的私有 AI 方案,起点不是选最大的模型,而是明确使用人数、接入系统、网络策略与模型权重许可。这一页是介绍材料,不是部署动作。
本页为本地介绍页(演示):不安装 Ollama、不拉取模型、不启动推理服务、不连接后端、不部署、不覆盖任何已有页面。