
AI训练与推理
训练关注模型规模、显存与节点通信;在线推理还要兼顾并发、响应时间和服务稳定性,不能用同一套指标选型。
什么是高性能计算
高性能计算通过高性能节点或多个节点的协同,处理普通办公设备难以承担的计算任务。GPU适合经过适配的并行算法,但不是所有软件都能直接加速;CPU、大内存和数据通路同样决定平台是否适用。
训练关注模型规模、显存与节点通信;在线推理还要兼顾并发、响应时间和服务稳定性,不能用同一套指标选型。
从软件支持与求解方式确认CPU、GPU或混合路线。并行许可、内存需求和结果精度都影响实际可用配置。
任务是否能拆分、文件如何共享、输入输出有多密集,决定是增加计算节点,还是先改善存储与队列管理。
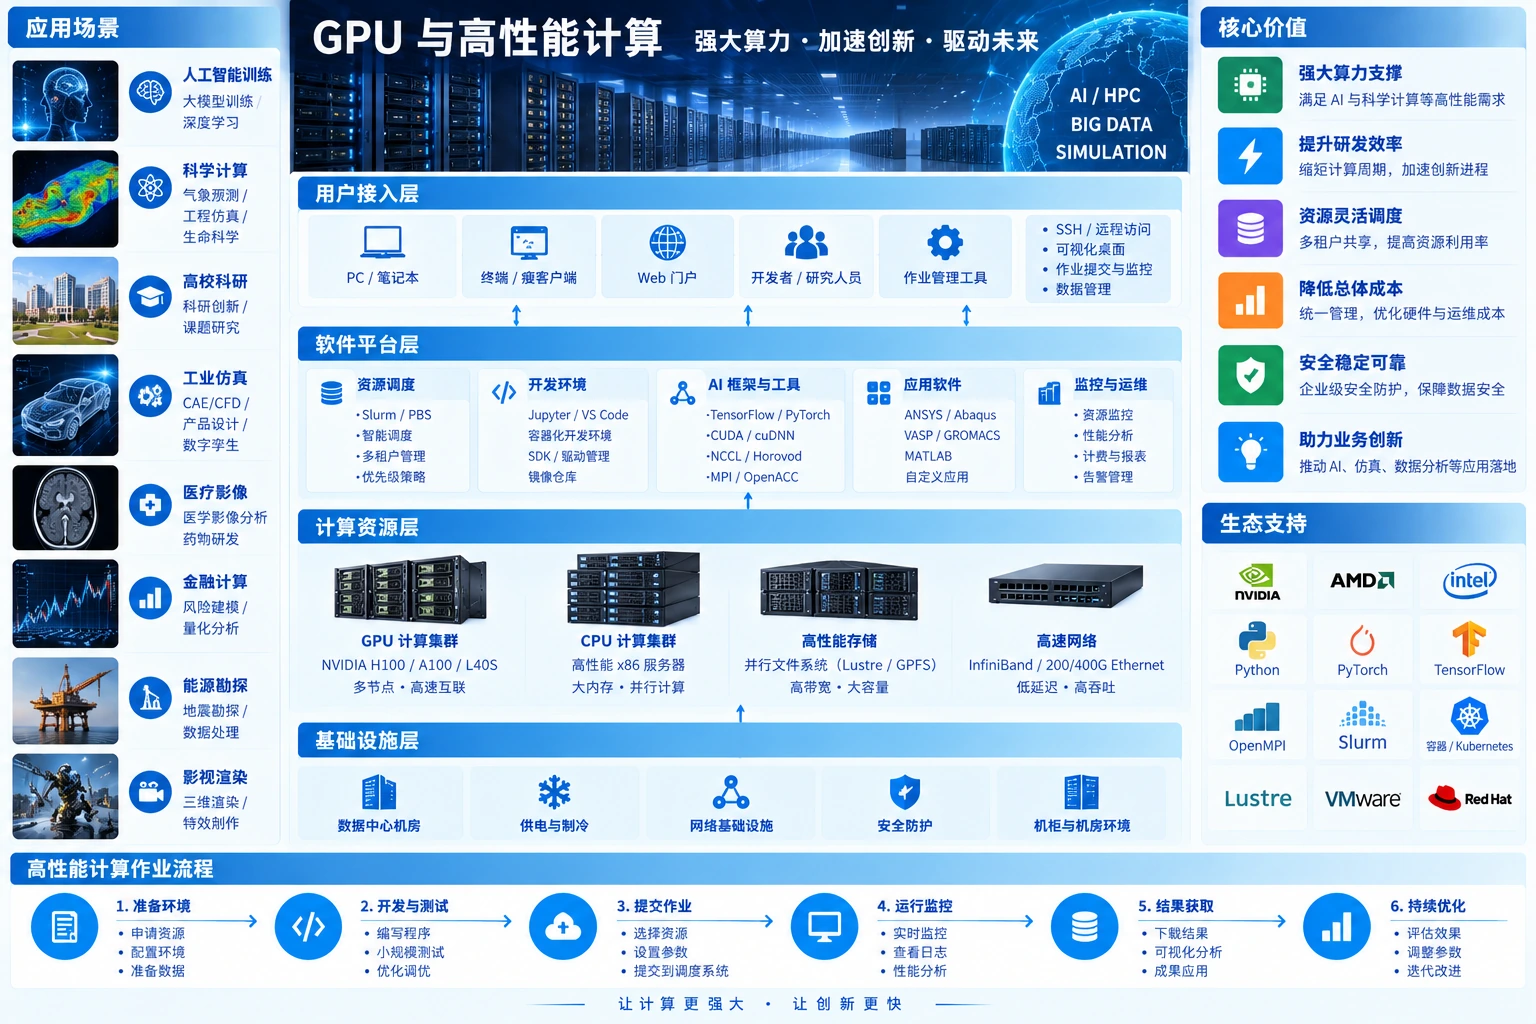
任务运行架构
使用者提交任务和资源需求,调度系统按队列与策略分配节点。任务执行时,计算节点通过数据网络访问存储;调度器管理任务,不承担全部计算数据的中转。
脚本 / 任务参数 / 数据路径
申请CPU、GPU、内存与时间
权限 / 配额 / 优先级
Slurm等作业系统按需选型
匹配驱动、库与应用环境
运行任务,回报状态
输入数据、模型检查点、计算结果
多节点任务另需匹配节点间互联
资源使用记录供容量与费用分析;失败重试、检查点恢复由应用和调度策略共同决定。
示意图以排队作业为例。在线推理、交互式开发与容器服务可采用不同入口和调度方式;动线只说明关系,不表示实测带宽或加速比。
配置的平衡
选型先确定任务能否运行,再比较运行效率。模型放不下显存、多个节点通信等待、数据供给跟不上,都可能让高规格设备无法发挥作用。
选择运行方式
| 任务形态 | 运行方式 | 优先关注 |
|---|---|---|
| 周期性仿真 / 批量训练 | 排队提交、按任务分配与释放资源 | 完成时间、公平调度、失败定位和结果复现 |
| 交互式研究 / 开发 | 受控开发会话、共享环境或专用节点 | 环境一致性、用户隔离、资源占用与数据权限 |
| 在线推理 / API服务 | 持续运行的服务,可结合容器编排 | 并发、尾延迟、版本发布与可用性 |
需要持续运行的容器服务,可进一步了解Kubernetes;跨本地与云端配置算力时,还需评估数据传输时间、费用和任务可迁移性。
用任务验证平台
先确定一组可复现的样例和验收条件,再安装、调优与扩展。性能记录同时保留软件版本、输入规模、节点数量和资源配置,避免把不同条件下的数字放在一起比较。
确认正确性、运行时间和资源占用,发现环境或应用适配问题。
测试多人共享、单机多卡或多节点表现,识别通信与存储等待。
观察温度、功耗、告警和失败处理;按应用能力验证检查点恢复。
常见问题
不一定。部分仿真、数据处理或传统科学计算依赖CPU性能与大内存;适配GPU的算法才可能利用GPU并行能力。先确认软件支持、许可证和实际负载,再决定CPU、GPU或混合配置。
不能直接推断。加速效果受到任务并行度、显存容量、节点通信、数据读取与软件实现影响。应使用真实模型或算例,对比单卡、单机和多节点的有效运行时间与资源利用率。
面向排队运行、资源预约及批处理作业,可以评估Slurm或同类作业调度系统;面向容器化服务和应用生命周期,可以评估Kubernetes及所需扩展。两者并非默认串联,取决于任务形态和运维方式。
提供主要软件与版本、任务样例、数据量、并发人数、单次任务时间或服务时延目标,以及现有机房供电、制冷和网络条件。使用可脱敏样例即可,敏感业务数据按约定方式处理。
煜企从实际计算任务出发,提供CPU/GPU服务器、存储与互联选型供货,完成集群部署、驱动与软件环境配置、调度接入及任务联调。应用许可、算法改造和专业求解结果由约定责任方共同确认。
下一步 / 技术沟通
带上软件版本、数据规模、并发人数和希望改善的运行时间,先判断瓶颈在哪里。